IA générative image : de la diffusion au marquage des photos
L’essentiel
Comment un modèle de diffusion fabrique une image à partir d’un bruit, et quelles traces il laisse : C2PA, SynthID, AI Act.
 Clara Blaise
11 min
Une image produite par IA générative ne sort pas d’une banque de photos. Les médias qui suivent l’IA générative au quotidien testent régulièrement de nouveaux générateurs, de Midjourney à Flux en passant par Leonardo.
Cette image naît d’un bruit aléatoire que le modèle nettoie, étape après étape, en se laissant guider par votre texte. Derrière ces outils, un principe revient dans la recherche publiée, la diffusion, et plusieurs grands éditeurs laissent désormais dans le fichier une trace de leur passage.
Comprendre ces deux moments, la fabrication puis le marquage, aide autant ceux qui créent des images que ceux qui les publient. Depuis le 2 août 2026, le second n’est d’ailleurs plus seulement une bonne pratique en Europe.
Partir du bruit : le principe de la diffusion
Les modèles dits « de diffusion » sont au cœur de la génération d’images décrite dans la littérature scientifique. Leur principe a été proposé en 2015 par Jascha Sohl-Dickstein et ses coauteurs, puis rendu performant pour l’image en 2020 par trois chercheurs de Berkeley, Jonathan Ho, Ajay Jain et Pieter Abbeel, dans l’article « Denoising Diffusion Probabilistic Models ».
L’idée tient en deux temps. À l’entraînement, on prend une vraie image et on lui ajoute un peu de bruit, puis encore un peu, jusqu’à ce qu’il ne reste qu’une neige de pixels sans aucune forme. Dans leurs expériences, les auteurs découpent ce chemin en 1 000 étapes.
Le modèle apprend alors à faire le trajet inverse : à chaque étape, deviner quelle part du bruit retirer pour revenir vers une image plausible.
À la génération, il n’y a plus de photo de départ. Le modèle part d’un bruit tiré au hasard et applique, étape par étape, ce qu’il a appris. Une forme apparaît, puis des contours, puis des détails.
C’est aussi pour cette raison que deux générations lancées avec le même texte ne donnent en général pas la même image : sauf si l’on fixe sa « graine » (seed), le bruit de départ change à chaque fois.
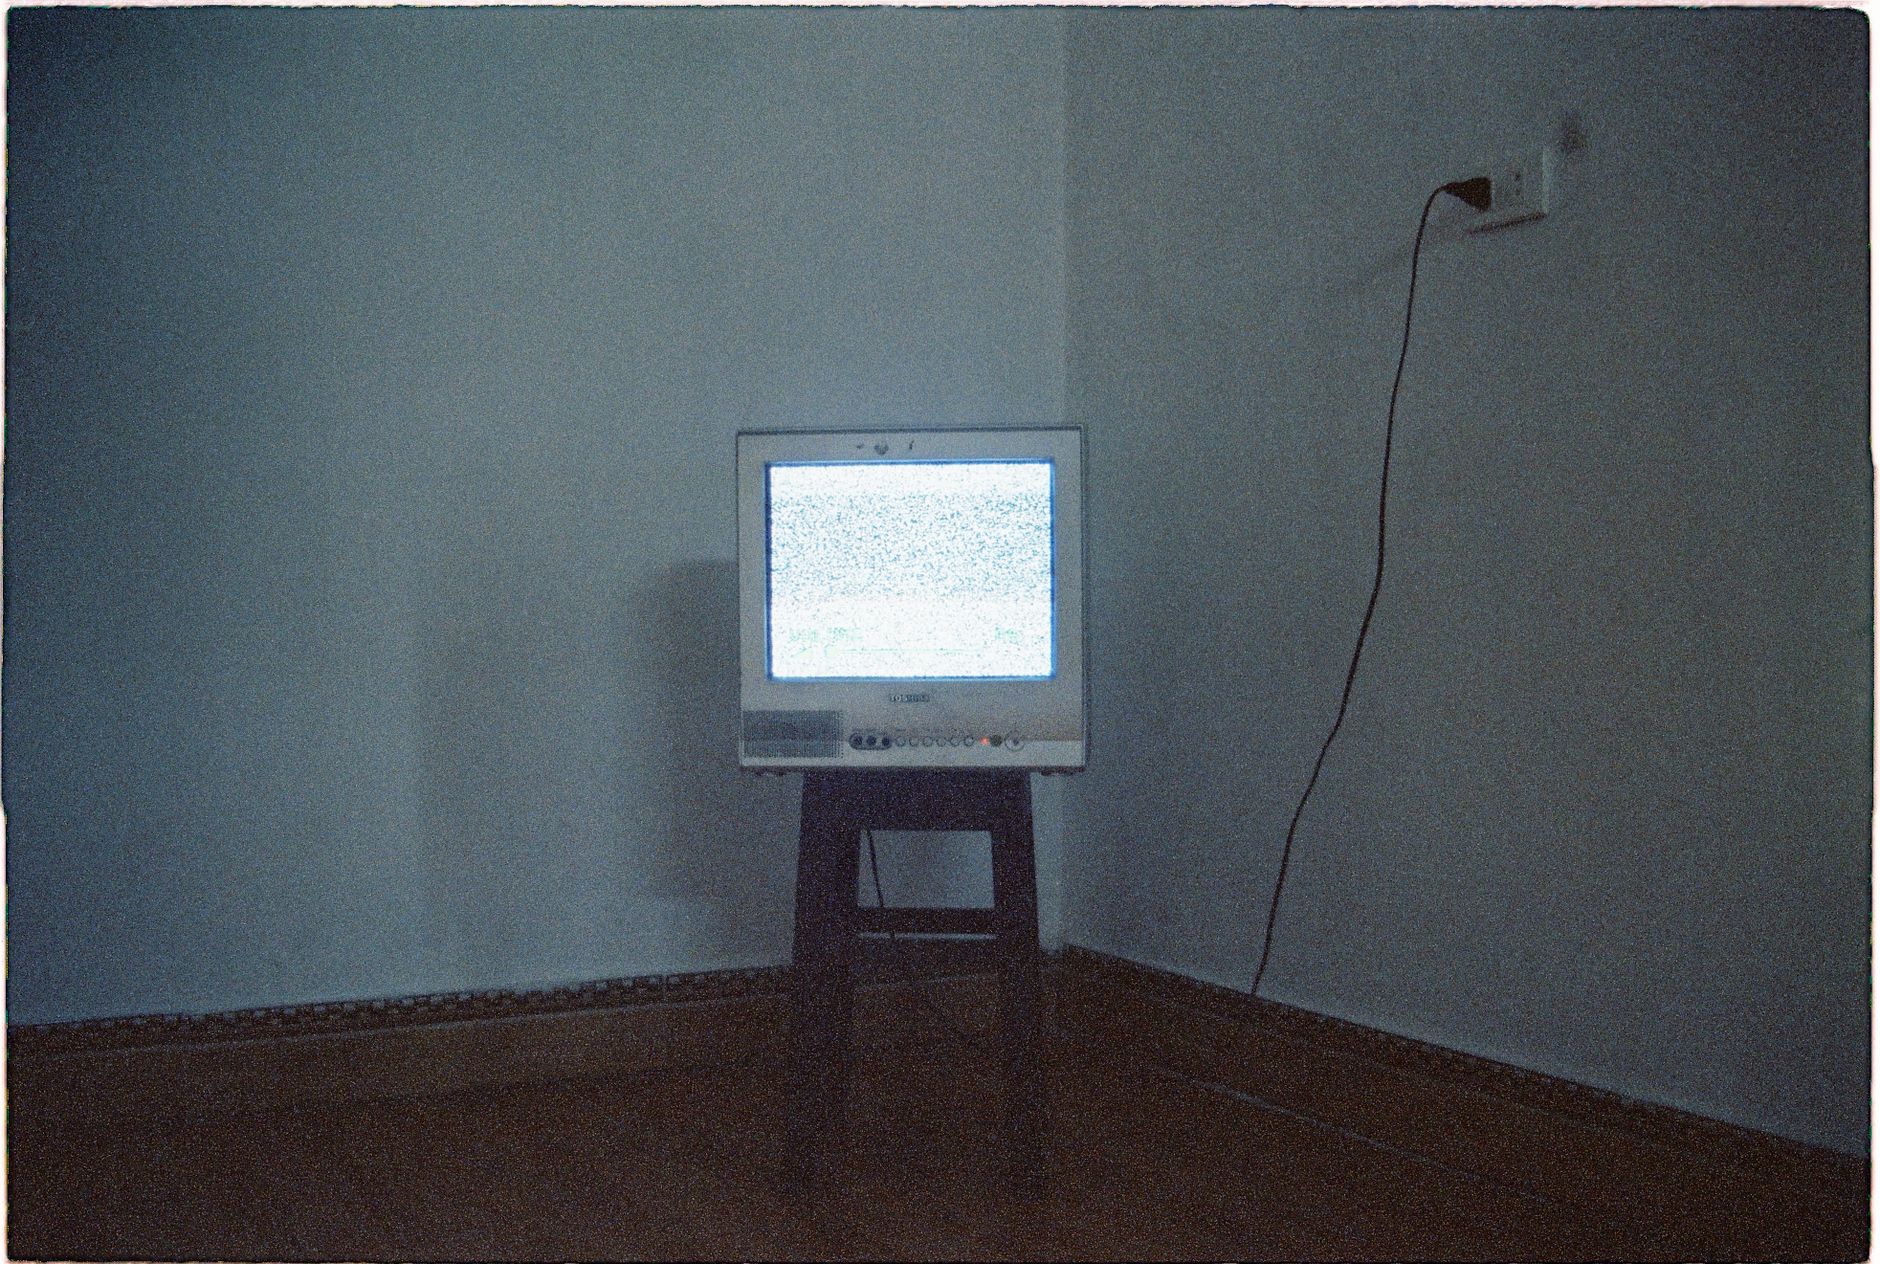
Cette image de neige n’est qu’une analogie, mais elle aide à retenir l’essentiel : le modèle ne colle pas des morceaux de photos existantes. Il transforme un bruit en image, en s’appuyant sur ce qu’il a appris de millions d’exemples.
Du texte à l’image : le rôle de l’espace latent
Travailler directement sur des millions de pixels coûte très cher en calcul. Fin 2021, une équipe des universités de Munich et de Heidelberg, menée par Robin Rombach, a proposé une parade dans l’article « High-Resolution Image Synthesis with Latent Diffusion Models » : faire la diffusion dans un espace compressé, appelé espace latent.
Un premier réseau, un autoencodeur, résume l’image dans une grille beaucoup plus petite. Avec un facteur de réduction de 8, retenu dans plusieurs de leurs modèles, une image de 512 pixels de côté est traitée comme une grille de 64 sur 64. Le débruitage se fait dans cette grille, puis un décodeur la retransforme en image pleine taille.
Reste à faire obéir le modèle à votre demande. Les auteurs ont ajouté des couches dites d’attention croisée, qui injectent le texte à chaque étape du débruitage. Leur modèle texte-image comptait 1,45 milliard de paramètres, avait été entraîné sur le jeu de données public LAION-400M, et les exemples publiés ont été générés en 200 étapes.
Ces chiffres viennent de travaux de recherche publiés. Les éditeurs de générateurs grand public ne détaillent pas, en revanche, le nombre d’étapes, la taille ou les données d’entraînement de leurs modèles en production. Nous ne les avançons donc pas ici : seul le principe est documenté publiquement.
Les traces laissées au moment de la création
Une fois l’image fabriquée, deux familles de marquage permettent d’en garder l’origine. La première passe par les métadonnées, ces informations rangées dans le fichier à côté des pixels. La seconde inscrit une marque dans les pixels eux-mêmes.
Côté métadonnées, un standard ouvert est porté par la C2PA, la Coalition for Content Provenance and Authenticity. Elle publie un standard technique ouvert pour établir l’origine d’un contenu et les modifications qu’il a subies.
Son comité de pilotage réunit notamment Adobe, Amazon, la BBC, Google, Meta, Microsoft, OpenAI, Sony et TikTok. La coalition compare ses « Content Credentials » à une étiquette nutritionnelle du contenu numérique, lisible par tous.
OpenAI indique par exemple que les images générées avec ChatGPT et avec son API portent ces métadonnées C2PA. L’éditeur reconnaît aussi leur limite : elles peuvent être retirées, par accident ou volontairement.
La plupart des réseaux sociaux les suppriment à l’envoi, et une simple capture d’écran suffit à les perdre. Notre article pour reconnaître une image générée par IA détaille ce que ces informations permettent de vérifier, côté lecteur.
Le saviez-vous ?
Le vocabulaire de l’IPTC, utilisé par les agences de presse pour décrire l’origine d’une image, distingue deux cas. Une image entièrement créée par un modèle entraîné sur des contenus réels est dite « trainedAlgorithmicMedia ».
Une photo seulement complétée ou corrigée par une IA générative, par exemple pour effacer un objet ou prolonger le cadre, relève d’une autre catégorie, dite composite.
Source : IPTC, vocabulaire « Digital Source Type », consulté le 28/09/2026.
Cette nuance compte pour la suite : une retouche ponctuelle et une image fabriquée de toutes pièces ne disent pas la même chose au lecteur, et la réglementation ne les traite pas tout à fait de la même manière.
La seconde famille de marquage vise justement à survivre là où les métadonnées disparaissent. Google DeepMind a développé SynthID, un filigrane invisible à l’œil, intégré aux pixels au moment de la génération.
D’après Google, il est conçu pour résister au recadrage, aux filtres et à la compression avec pertes. Le groupe l’applique aux contenus produits par ses outils d’IA générative grand public, dont Gemini.
Le 20 mai 2025, Google annonçait que plus de 10 milliards de contenus avaient déjà été marqués avec SynthID, et lançait un portail, SynthID Detector, capable de rechercher cette marque dans un fichier. L’article de recherche consacré à la version image, publié en octobre 2025, évoque lui aussi plus de dix milliards d’images et d’images vidéo marquées.
Aucune des deux méthodes n’est infaillible, et aucune n’est universelle : un filigrane propre à un éditeur ne se lit qu’avec l’outil de cet éditeur. Nous n’avons trouvé aucune source publique chiffrant la part des images générées qui conservent encore leurs marques une fois publiées en ligne.
Ce que l’AI Act impose depuis le 2 août 2026
Le règlement européen sur l’intelligence artificielle, l’AI Act (règlement (UE) 2024/1689), consacre son article 50 à la transparence. Il s’applique depuis le 2 août 2026 et vise deux acteurs distincts.
Les fournisseurs de systèmes qui génèrent des images, du son, de la vidéo ou du texte doivent faire en sorte que les contenus produits soient marqués dans un format lisible par une machine et détectables comme générés ou manipulés artificiellement.
Les solutions retenues doivent être efficaces, interopérables, robustes et fiables, dans la mesure où c’est techniquement faisable. Le texte prévoit des exceptions, notamment pour les fonctions d’aide à l’édition qui ne modifient pas substantiellement le contenu fourni.
Les utilisateurs professionnels, que le texte appelle déployeurs, qui diffusent un hypertrucage (deepfake) doivent indiquer que le contenu a été généré ou manipulé.
Pour une œuvre manifestement artistique, créative, satirique ou de fiction, l’obligation se limite à signaler l’existence de ce contenu d’une manière qui ne gêne pas l’œuvre.
L’information doit être donnée de façon claire, au plus tard lors de la première exposition du public. Le cadre juridique propre aux deepfakes est détaillé dans un article dédié.
Un calendrier a cependant été aménagé par le règlement dit « omnibus », le règlement (UE) 2026/1744, publié au Journal officiel de l’Union européenne le 24 juillet 2026.
Les systèmes déjà mis sur le marché avant le 2 août 2026 disposent d’un délai de grâce de quatre mois, jusqu’au 2 décembre 2026, pour appliquer l’obligation de marquage. Les autres obligations de transparence de l’article 50 restent, elles, applicables depuis le 2 août 2026.
Ce découpage explique pourquoi vous pouvez encore croiser, jusqu’au 2 décembre 2026, des images générées sans aucun marquage lisible, sans que cela signifie que l’outil utilisé enfreint la règle.
Créer et publier une image générée : les bons réflexes
Si vous créez des images avec un générateur, gardez le fichier d’origine tel qu’il a été exporté. C’est lui qui porte les métadonnées de provenance quand l’outil en ajoute. Une capture d’écran ou un passage par une messagerie peut les effacer sans que vous le remarquiez.
Si vous publiez une image générée réaliste, montrant une personne, un lieu ou un événement qui pourrait passer pour vrai, une mention claire reste le réflexe le plus simple. Elle évite toute confusion chez le lecteur et correspond à l’esprit de l’article 50.
À l’inverse, si vous recevez une image dont l’origine vous intrigue, l’absence de marque ne prouve rien dans un sens ni dans l’autre. Les indices visuels et les outils décrits dans notre guide pour détecter des images générées par IA prennent alors le relais.
Questions fréquentes
Retenez l’essentiel : une image générée naît d’un bruit que le modèle transforme pas à pas, et sa traçabilité repose désormais sur un marquage, par métadonnées ou par filigrane, que la réglementation européenne rend progressivement obligatoire.
Clara Blaise
recherche par image, reconnaissance faciale, vie privée et droit à l'image
Clara teste les moteurs de recherche par image et de reconnaissance faciale, et suit ce que la CNIL, le RGPD et l'AI Act permettent vraiment. Chaque test est refait sur ses propres photos avant publication.
Voir tous les articles de Clara Blaise →
Mis à jour le 28 septembre 2026